두 명목 변수 사이의 상관 관계 측정 방법을 찾으려면 어떻게합니까?


11

사람들이 특정 스마일을 사용하여 자신의 출신 국을 대표하고 입국 한 것을 선택하는 설문 조사가 이루어졌습니다. 텍스트 응답을 숫자로 코딩했습니다.

사람들이 어디에서 왔으며 그들이 선택한 표현 사이의 상관 관계 수준을 확인하려면 어떤 형태의 분석을 사용해야합니까 (SPSS에서 선호)?

답변:


9

명목-명목 연관성에는 여러 가지 조치가 있습니다.

phi 계수, 우발 계수 (제곱 테이블에 적용되는 것으로 생각되므로 적합하지 않을 것입니다), Cramer의 V 계수, 람다 계수 및 불확실성 계수가 있습니다. 여전히 의심의 여지가 없습니다.

많은 사람들이 카이 제곱 통계량의 함수로 밝혀졌습니다.

(하나 이상의 서수 변수가있는 경우 해당 상황에 적합한 다른 계수가 많이 있습니다.)

이 위키 백과 페이지 에는 내가 언급 한 것들이 나열되어 있습니다.

나는 SPSS가 직사각형 공칭 대 명목 상황과 일치한다고 생각하는 것을 계산할 수 있다고 생각합니다. 적어도 나는 phi와 Cramer의 V와 람다 계수의 경우 확실합니다.
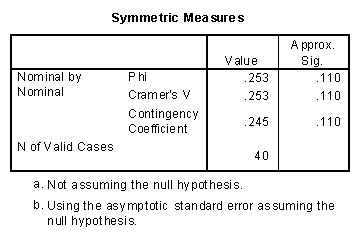
피와 V

람다

( 여기 및 여기 에서 표 )


1
저는 Cramer 's V를 사용할 생각을했지만 통계학 심리학 (하우웰)에서 다음과 같이 읽었습니다. "V의 문제는 두 가지 이상의 범주가있을 때 간단한 직관적 인 해석을하기가 어렵다는 것입니다. 주문한 차원에서. " 나는 그가 무슨 뜻인지 잘 모르겠습니다.
— masoftheund

1
나는 그러한 비판이 대부분의 비판에 해당한다고 생각합니다. 직사각형 ( ) 공칭 공칭 연관입니다. 직관이 얼마나 될까요? m×n
— Glen_b-복지 모니카

꽤 많이. 설문 조사는 연구의 일부일 뿐이므로 다른 출처에서도 결론을 도출 할 수 있습니다. 또한 상관 관계가 있는지 알면 충분합니다.
— masoftheund

5
사각형 테이블에서 거의 모든 명목상의 명목 연관성 측정이 그 자체로 많은 직관력을 전달하지는 않을 것이지만, 그 점은 훌륭하게 들립니다 (직관을 전달할 주제 지식이 있음). 나는 그것이 Cramer 's V에 대한 특별한 비판이라고 생각하지 않습니다. 예를 들어, V는 phi에서 단조롭습니다. 비판은 확실히 다른 하나에도 적용됩니다.
— Glen_b-복지 모니카

1

연관에 대해 더 많은 통찰력을 원하면 로그 선형 모형을 이러한 데이터에 맞출 수 있습니다. 스타터의 경우 (분석> 로그 선형> 일반) 또는 GENLOG.

당사 사이트를 사용함과 동시에 당사의 쿠키 정책과 개인정보 보호정책을 읽고 이해하였음을 인정하는 것으로 간주합니다.
Licensed under cc by-sa 3.0 with attribution required.